前面三節我們認識了混元、GLM、MiniMax、Kimi 四個系列。這一節講最後一個內建系列——DeepSeek,並給出一個更實用的話題:多款模型怎麼搭配著用,而不是隻守著一個模型。
一、DeepSeek 系列:旗艦雙煞#
DeepSeek 系列有兩款旗艦模型,都支援 1M 超長上下文,區別在於速度與深度的側重。
1. Deepseek-V4-Flash:速度優先的旗艦#
| 屬性 | 說明 |
|---|---|
| 定位 | 旗艦模型 |
| 上下文 | 1M 超長視窗 |
| 側重 | 速度優先 |
| 思考模式 | 支援 |
亮點是旗艦級能力 + 速度優先 + 1M 上下文。既要處理超長內容,又不想等太久時,它是首選。
適合:長文件處理但要求響應快、大規模內容快速分析。
2. Deepseek-V4-Pro:深度優先的旗艦#
| 屬性 | 說明 |
|---|---|
| 定位 | 旗艦模型 |
| 上下文 | 1M 超長視窗 |
| 側重 | 深度優先 |
| 思考模式 | 支援 |
亮點是旗艦級深度能力 + 1M 上下文。同樣是 1M 視窗,但更偏向質量,願意花時間算得更深。
適合:超長內容的深度分析、對結果質量要求極高的複雜任務。
兩款怎麼區分#
| 維度 | V4-Flash | V4-Pro |
|---|---|---|
| 上下文 | 1M | 1M |
| 側重 | 速度優先 | 深度優先 |
| 適合 | 要快 | 要準 |
二、模型搭配策略#
真正高效的使用者,不會從頭到尾只用一個模型,而是按任務型別搭配使用。這裡給幾個常見搭配思路。
思路 1:程式碼用 DeepSeek,文件用混元#
- 寫程式碼 / 調程式碼:用 DeepSeek 系列,旗艦級推理 + 長上下文,適合理解整個程式碼庫
- 寫文件 / 做文案:用混元 Hy3,推理強還暫時免費,潤色、總結都合適
思路 2:雙模型搭配,各取所長#
不同模型擅長的事不一樣,組合起來能覆蓋更廣:
| 任務 | 推薦模型 | 理由 |
|---|---|---|
| 程式碼開發 | DeepSeek-V4-Pro / Kimi-K2.7-Code | 旗艦推理 / 程式設計專精 |
| 長文件分析 | GLM-5.21 / Deepseek-V4-Flash | 1M 上下文 |
| 圖文混合 | GLM-5v-Turbo / MiniMax-M3 | 原生多模態 |
| 複雜自主任務 | MiniMax-M3 / Kimi-K3 | Agent / 長程能力 |
| 日常省錢 | MiniMax-m2.7 / Hy3 | 價效比 / 免費 |
核心原則:讓模型去適配任務,而不是讓任務遷就模型。
三、切換方式與注意事項#
怎麼切換#
在對話介面的模型選擇框裡直接切換,無需重啟或重新配置。
兩個關鍵點#
- 切換後新對話生效:開始新對話才會用新模型
- 已有上下文保持不變:正在進行的對話不會因為切換而丟失內容
所以推薦的做法是:每個新任務開一個新對話,按任務型別選合適的模型。
四、新手建議#
如果你剛開始用,不確定怎麼搭配,可以按這個順序摸索:
- 先用平衡模式 + GLM-5.1:跑通日常任務,建立體感
- 遇到程式碼任務換 DeepSeek 或 Kimi-Code:感受旗艦和程式設計專精的差異
- 遇到長內容換 GLM-5.21 / DeepSeek:體驗 1M 上下文的威力
- 逐步形成自己的搭配習慣:哪類任務用哪個模型,用順手了就穩定下來
小結#
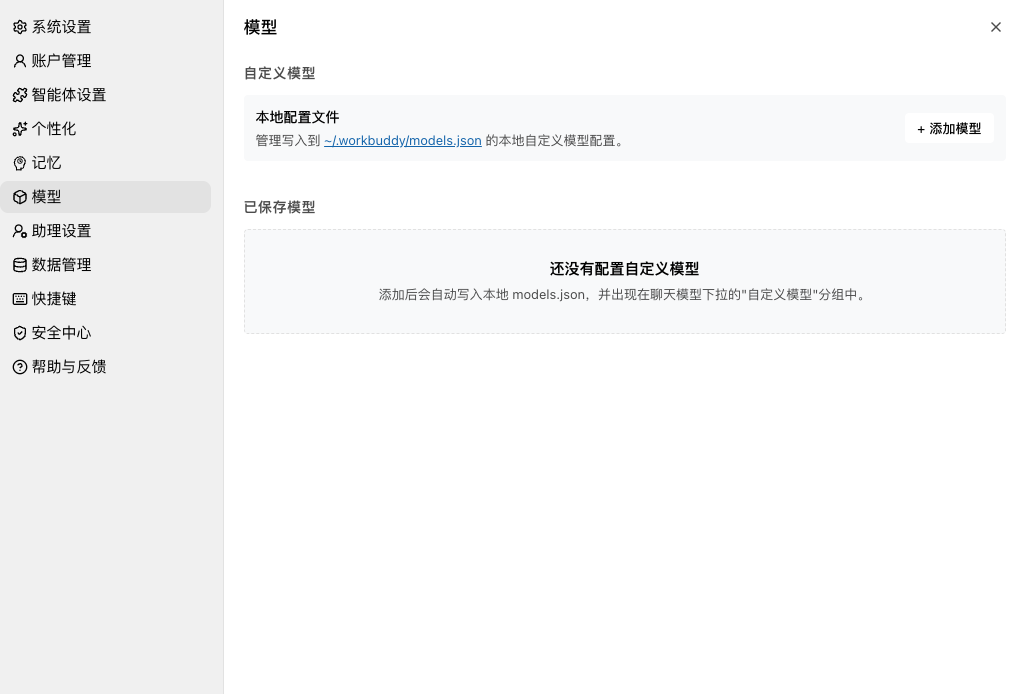
DeepSeek 兩款旗艦都支援 1M 上下文,Flash 求快、Pro 求深。更重要的是學會按任務搭配模型:程式碼用 DeepSeek、文件用混元、長內容用 1M 視窗模型、圖文用多模態模型。下一章,我們看如何接入 WorkBuddy 內建之外的"自定義模型"。